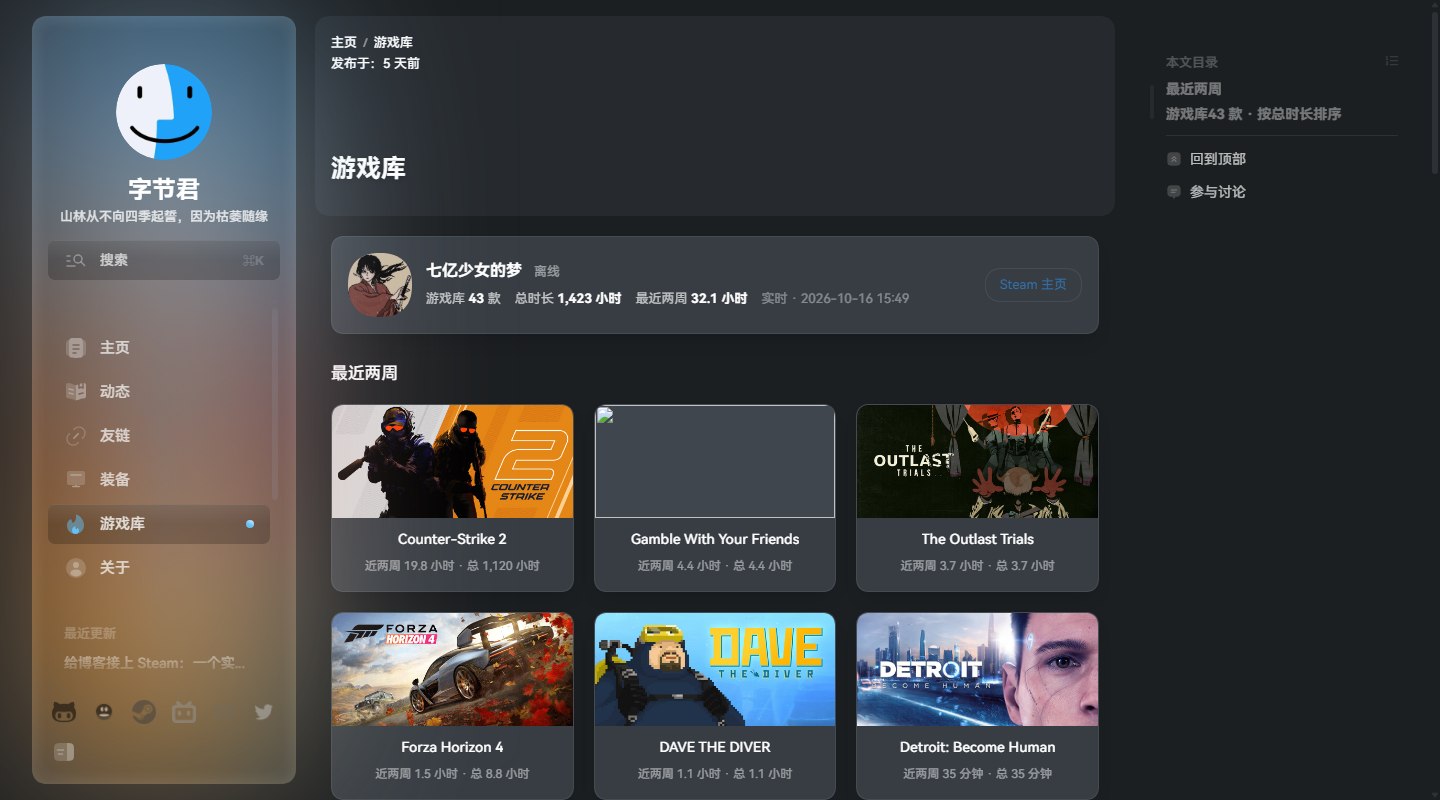
前阵子给博客加了装备图鉴,做完就想着再搞一个游戏库页面:把 Steam 库里的游戏、
各自的游玩时长,还有「现在正在玩什么」都摆出来。页面本身不难,难的是怎么让它是活的——
毕竟我打开 Steam 的时间和写博客的时间不一样,硬编码一堆游戏名过两天就过期了。
现在它长这样:
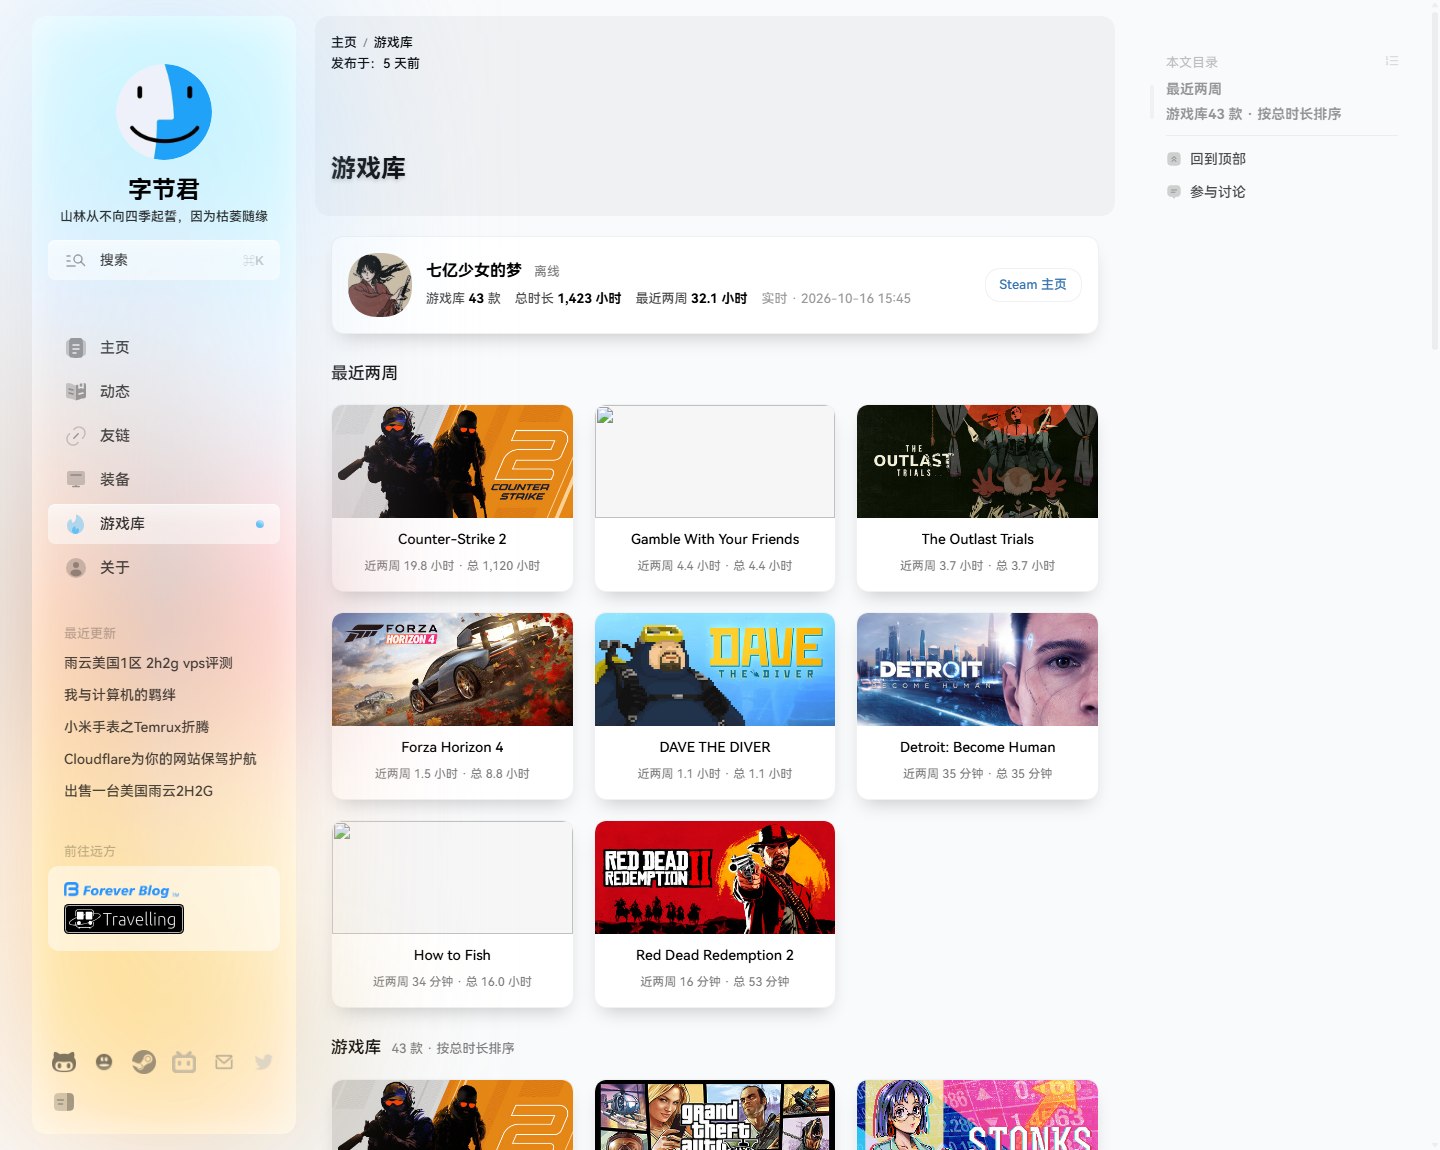
头像、昵称、「最近两周」和全库时长都是从 Steam 拉的,打开页面时会自动刷新一次。
 为什么不能在前端直接调 Steam 接口
想法很直接:页面上 fetch 一下 Steam 的接口不就行了?但有两个拦路虎:
CORS:api.steampowered.com 不返回 Access-Control-Allow-Origin,浏览器直接请求会被拦下来;密钥:Steam Web API 要带 API key,而它是账号凭证,绝不能写进前端代码——静态博客的 JS 人人可见。
所以中间必须有个”代理”:它拿着 key 去问 Steam,把结果用带 CORS 的形式吐给页面。
这种东西用 Cloudflare Worker 做最合适——免费额度足够,几十行代码,还顺手能加缓存。
整体架构:快照 + 实时
我把它拆成两条通路,各管一件事:
| 通路 | 什么时候更新 | 作用 |
|---|---|---|
| 构建时快照 | 每次部署(hexo generate) | 把游戏库渲染成静态 HTML——没 JS 也能看,SEO 也友好,数据是”最近一次构建时”的 |
| 客户端实时刷新 | 每次打开页面 | 向 Worker 要一次实时数据,只更新「正在玩」、时长、最近两周;失败就静默保持快照 |
这样分工的好处是:Worker 挂了、网络抽风、公司网络拦了,页面都还是完整的(只是数字旧一点);
反过来,Worker 正常时「正在玩」这类信息是分钟级的。
部署指南
第一步:拿 Steam API key,并把隐私放开
- 打开 https://steamcommunity.com/dev/apikey(要登录 Steam),域名随便填
localhost就行,拿到 key; - 个人资料 → 编辑 → 隐私设置,把「游戏详情」设为公开。
第 2 步很容易漏:它不是公开的话,接口返回的 games 是空数组(接口本身还是 200,不会报错),
页面就会显示”库为空”。我第一次就是这么被自己绕进去的。
第二步:部署 Worker
Worker 我单独放了一个仓库:**Bytelv/steam-worker**。
1 | git clone https://github.com/Bytelv/steam-worker.git |
不知道自己的 steamID64?用 key 调一次就行:
1 | curl "https://api.steampowered.com/ISteamUser/ResolveVanityURL/v1/?key=你的key&vanityurl=你的个性网址" |
部署完 curl https://你的域名/ 应该能拿到一份 JSON;加 ?debug=1 还会带一个X-Steam-Cache 头,写着各级缓存是命中还是回源。
第三步:绑自己的域名(重要)
*.workers.dev workers.dev 在国内被 DNS 污染:实测解析到 face:b00c:… 这类假地址,curl 直接连不上。就算 Worker 部署成功,你的国内访客也永远拉不到实时数据。
正确做法是绑自己的域名:Cloudflare Dashboard → Workers & Pages → 选中你的 Worker →
Settings → Domains & Routes → Add → Custom Domain,填一个子域名(我用的是 steam.4123010.xyz)。
第四步:博客这边用起来
我的博客是 Hexo,所以做了个 {% steam %} 标签,配置集中在 source/_data/steam.yml:
1 | steamid: '76561199xxxxxxxxx' # steamID64 |
再跑一次抓取脚本生成静态快照(fetch.js 也在博客仓库里):
1 | node tools/steam/fetch.js --key 你的key |
然后 hexo clean && hexo server 就能看到了。**注意一定要 hexo clean**——改 _data/*.yml
不会让 Hexo 失效页面缓存,不清的话你会对着”改了数据页面纹丝不动”怀疑人生。
踩过的坑
顺手记一下这一路踩的坑,都是实测出来的:
- Node 的 fetch 不认我本机代理的证书
自己在本地跑抓取脚本时报 fetch failed,打印出 cause 才看到是 UNABLE_TO_GET_ISSUER_CERT_LOCALLY:
Node 用的是自带的 CA 库,而我本机挂着代理,证书链是代理签的,Node 不认识;curl 走系统证书库就没事。
所以脚本里内置了 curl 兜底(只在连接/TLS 层失败时兜,HTTP 4xx 不兜,免得掩盖真实错误)。
在 GitHub Actions 上跑是正常走原生 fetch 的。
- 库里没封面的游戏会被拉成一坨糊图
Steam 的封面图按 https://cdn.cloudflare.steamstatic.com/steam/apps/<appid>/header.jpg 拼,
但有些游戏就是没有这张图,CDN 会回一张 32×32 的默认图——放进卡片里拉大就是一坨糊的(还不报错,因为 HTTP 200)。
处理办法是按 naturalWidth 判断尺寸,依次降级:capsule_616x353.jpg → 还是太小就显示游戏名的文字占位。
我库里 43 款里有 2 款是这样的。
- 「排除清单」要两边同步
Worker 不知道你站点配置里想屏蔽哪些 appid(比如 Steamworks、Wallpaper Engine),
会把它们一起返回。如果只在构建时过滤,那页面刚打开(实时刷新后)它们就会冒出来,
总数还会从 43 变 44、总时长也跟着变——我确实撞上过这个不一致。
办法是把排除清单也写进页面(data-steam-exclude),客户端按同一份清单过滤,并且重算统计数字。
- 新加的 DNS 记录会被本机解析器负缓存
绑完自定义域,浏览器死活打不开,Resolve-DnsName 说”名称不存在”,
但 223.5.5.5 / 8.8.8.8 已经能解析出真实的 Cloudflare IP——原因是我之前探测过这个域名,
本机解析器把当时的 NXDOMAIN 缓存住了。ipconfig /flushdns 加等一会儿就好,
急着验证可以用 curl --resolve 或者 Chrome 的 --host-resolver-rules。
- multipart 上传 Worker 脚本要带 filename
如果你不用 wrangler、而是直接打 Cloudflare 的 API 传脚本,代码那一段必须写成:
1 | Content-Disposition: form-data; name="worker.js"; filename="worker.js" |
只写 name="worker.js" 会报 10021 Uncaught Error: No such module: worker.js——报错信息很迷惑,
实际上就是少了个 filename。
小结
技术栈就是三样:Steam Web API 提供数据、Cloudflare Worker 做代理和缓存、Hexo 标签 + 一小段前端 JS 负责呈现。
总共不到 400 行,效果是打开博客的「游戏库」页面就能看到我今天在玩什么。
代码都开源了:
- Worker:Bytelv/steam-worker
- 博客侧:Bytelv/MyBlogSource(
scripts/steam.js+tools/steam/)
页面在这里:blog.lvbyte.top/games/